米米的博客

做了一点微小的工作

笔者有一台小爱音箱,可惜它并不支持 AirPlay 协议。如果要将 Mac 上的音乐串流到这台音箱上播放,就需要通过蓝牙配对,体验并不理想。幸运的是,这个型号的音箱配备了 USB 接口,并且可以通过 USB 声卡的方式被电脑识别为音频输出设备。这就意味着,可以通过 Shairport Sync 等软件进行 AirPlay 协议配对,然后通过 USB 将音频流发送到这台音箱上播放。
这台音箱摆放位置旁边就是 NAS 服务器,运行着 TrueNAS Scale 25.04 系统。直接在 NAS 服务器上安装 Shairport Sync 并连接音箱是一个不错的选择。这个版本的 TrueNAS 支持运行 Docker 容器,因此软件安装上非常方便,不过在调试过程中还是踩了很多坑。本文记录一下安装过程,供参考。

检查 Alsa 配置

首先,通过 SSH 登陆到 TrueNAS 服务器上,执行cat /proc/asound/cards检查声卡是否正确识别:

1
2
3
4
5
admin@truenas[~]$ cat /proc/asound/cards
0 [PCH ]: HDA-Intel - HDA Intel PCH
HDA Intel PCH at 0x6005220000 irq 199
1 [Pro7990 ]: USB-Audio - 智能音箱 Pro-7990
Xiaomi Corporation 智能音箱 Pro-7990 at usb-0000:00:14.0-5, high speed

可以看到,智能音箱声卡已经被正确识别为Pro7990。接下来,我们需要检查 Alsa 的配置(特别是 Mixer)。虽然 TrueNAS 系统基于 Debian,但它本身并不包含 Alsa 工具,因此我们需要先创建一个 Ubuntu 容器,并将声卡设备映射进去。可以通过 TrueNAS 的 Web 界面创建一个 Docker 容器,选择「通过 YAML 进行安装」,并添加如下配置:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
services:
alsa-check:
command:
- bash
- '-c'
- sleep infinity
container_name: alsa_mixer_check
devices:
- /dev/snd:/dev/snd
environment:
- DEBIAN_FRONTEND=noninteractive
image: ubuntu:24.04
privileged: True
stdin_open: True
tty: True

Ubuntu 的 Docker 容器启动成功后,进入容器内部的命令行,安装 Alsa 工具:

1
2
apt update
apt install -y alsa-utils
阅读全文 »

在 Ubuntu 系统上,有时我们需要对某些内核模块进行定制化修改,例如更新补丁、进行调试或加入额外日志等。完整重新编译内核会非常耗时,但好消息是:Linux 的内核构建系统允许我们仅重新编译目标模块,而不需要构建整个内核。

本文介绍如何在 Ubuntu 上为当前正在运行的内核版本重新编译一个模块,并正确安装和加载它。示例模块为 kvm-intel.ko

准备内核源码

Ubuntu 提供了与当前内核版本在同一 ABI 下的源码,可以通过 apt-get 直接获取:

1
apt-get source linux-image-unsigned-$(uname -r)

执行后目录中通常会出现类似:

1
linux-hwe-6.8-6.8.0/

这就是 Ubuntu 为 HWE 6.8 系列内核提供的完整源码树。

同步配置与符号信息

Kernel module 的编译依赖两个关键文件:

  1. .config — 当前内核的编译配置
  2. Module.symvers — 内核导出的符号版本信息

这两者必须与正在运行的内核一致,否则编译出的模块会因为 ABI 不一致而无法加载。

我们将系统中的配置和符号文件复制到源码树中:

1
2
cp /boot/config-$(uname -r) .config
cp /usr/src/linux-headers-$(uname -r)/Module.symvers .

准备构建环境

执行:

1
2
make oldconfig && make prepare
make modules_prepare

当它们准备完成后,就可以只编译目标模块了。

只编译目标模块

Linux 内核允许使用 M=<path> 的方式仅构建某个目录下的模块,这大大缩短编译时间。

以 KVM 模块为例:

1
make -j$(nproc) M=arch/x86/kvm modules

只会编译:

  • arch/x86/kvm/kvm.ko
  • arch/x86/kvm/kvm-intel.ko(Intel 虚拟化支持)
  • arch/x86/kvm/kvm-amd.ko(如果是 AMD)

kvm-intel.ko 为例,编译完成后可以查看模块信息:

1
modinfo arch/x86/kvm/kvm-intel.ko

可以确认版本号、依赖项、符号是否正确。

替换内核模块

为了让系统使用我们自己编译的版本,需要将它复制到系统模块目录中:

1
2
sudo cp arch/x86/kvm/kvm-intel.ko \
/lib/modules/$(uname -r)/kernel/arch/x86/kvm/

然后更新模块依赖:

1
sudo depmod -a

这样系统就能识别新的模块文件。

加载模块

卸载旧模块后再加载新的模块。若旧模块已加载,可先移除:

1
sudo modprobe -r kvm_intel

然后加载我们编译过的模块,并附带参数:

1
sudo modprobe kvm_intel pt_mode=1

若加载成功,说明自定义模块已生效。

在家庭服务器环境或小型机房中,通过网络(PXE)启动服务器可以显著简化设备的安装流程。本文将介绍如何在 OpenWRT 路由器 + 一台内网 Linux 服务器的组合下,搭建可用于 UEFI 启动的 PXE 环境,并支持 iPXE、HTTP 启动等现代特性。

本文实验成功的环境:

  • 路由器:OpenWRT(系统版本 24.10)
  • TFTP/HTTP 服务器:一台内网 Linux 服务器(安装 Ubuntu 系统)
  • 客户端:支持 UEFI PXE 的服务器主板

PXE 启动原理

PXE(Preboot eXecution Environment)启动主要由以下步骤组成:

  1. 客户端通过网络发送 DHCP Discover
  2. DHCP 服务器返回 IP 地址,并附加 PXE 相关字段:
    • next-server(TFTP server 的 IP)
    • filename(要下载的启动文件,如 snponly.efi
  3. 客户端向 TFTP 服务器请求文件
  4. 使用下载到的引导器加载后续启动流程,例如:
    • iPXE(支持 HTTP、iSCSI 等)
    • Linux kernel + initrd

OpenWRT 的 dnsmasq 内置了 PXE 支持,并且可以方便地通过 LuCI 界面配置。

配置 TFTP 服务

首先,在内网 Linux 服务器上安装 TFTP 服务,用于提供必要的文件。以 tftpd-hpa 为例:

1
sudo apt install tftpd-hpa

编辑 /etc/default/tftpd-hpa

1
2
3
4
TFTP_USERNAME="tftp"
TFTP_DIRECTORY="/srv/tftp"
TFTP_ADDRESS=":69"
TFTP_OPTIONS="--secure"

重启服务:

1
sudo systemctl restart tftpd-hpa

配置 HTTP 服务

以 Nginx 为例:

1
sudo apt install nginx

重启服务:

1
sudo systemctl restart nginx
阅读全文 »

XG-140G-TF (ONU) 是诺基亚贝尔生产的一款光猫,为电信定制版本。这款光猫支持 2.5G 网口,配置非常不错,而且闲鱼上价格已经降到 40 元左右,性价比很高。相比于 XG-040G 等类似型号,XG-140G-TF (ONU) 的厚度更薄,适合弱电箱环境;带有语音功能,支持安装座机。本文记录一下这款光猫的配置过程,XG-040G 等型号的光猫也可以参考。

获取旧光猫配置

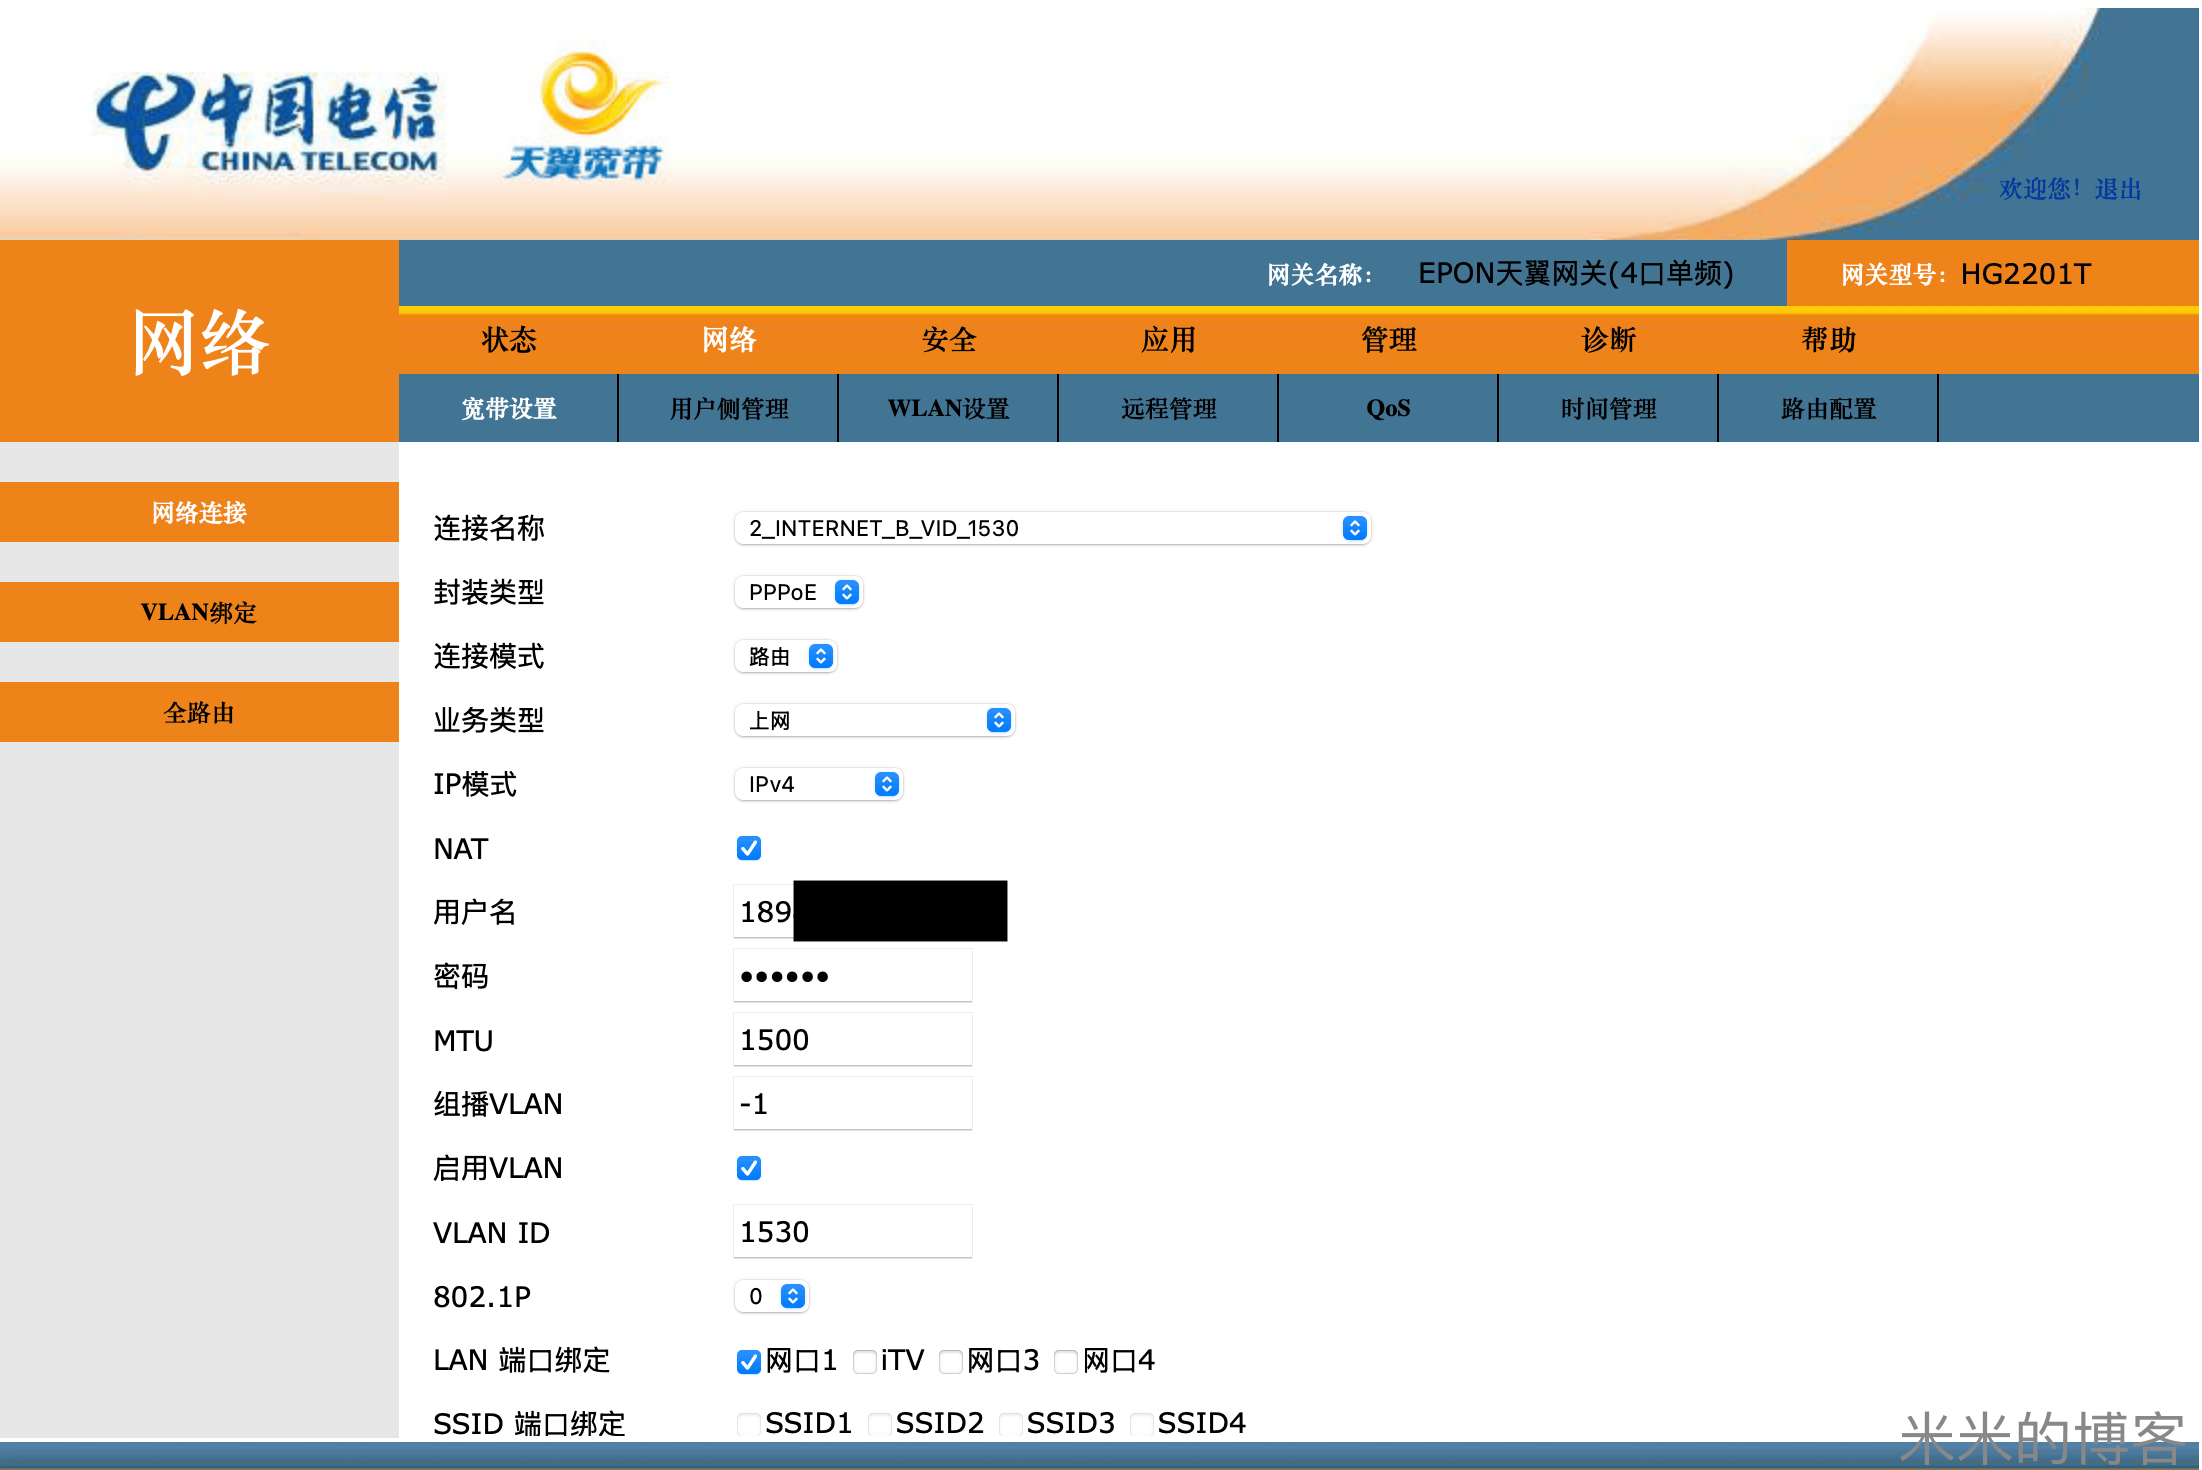
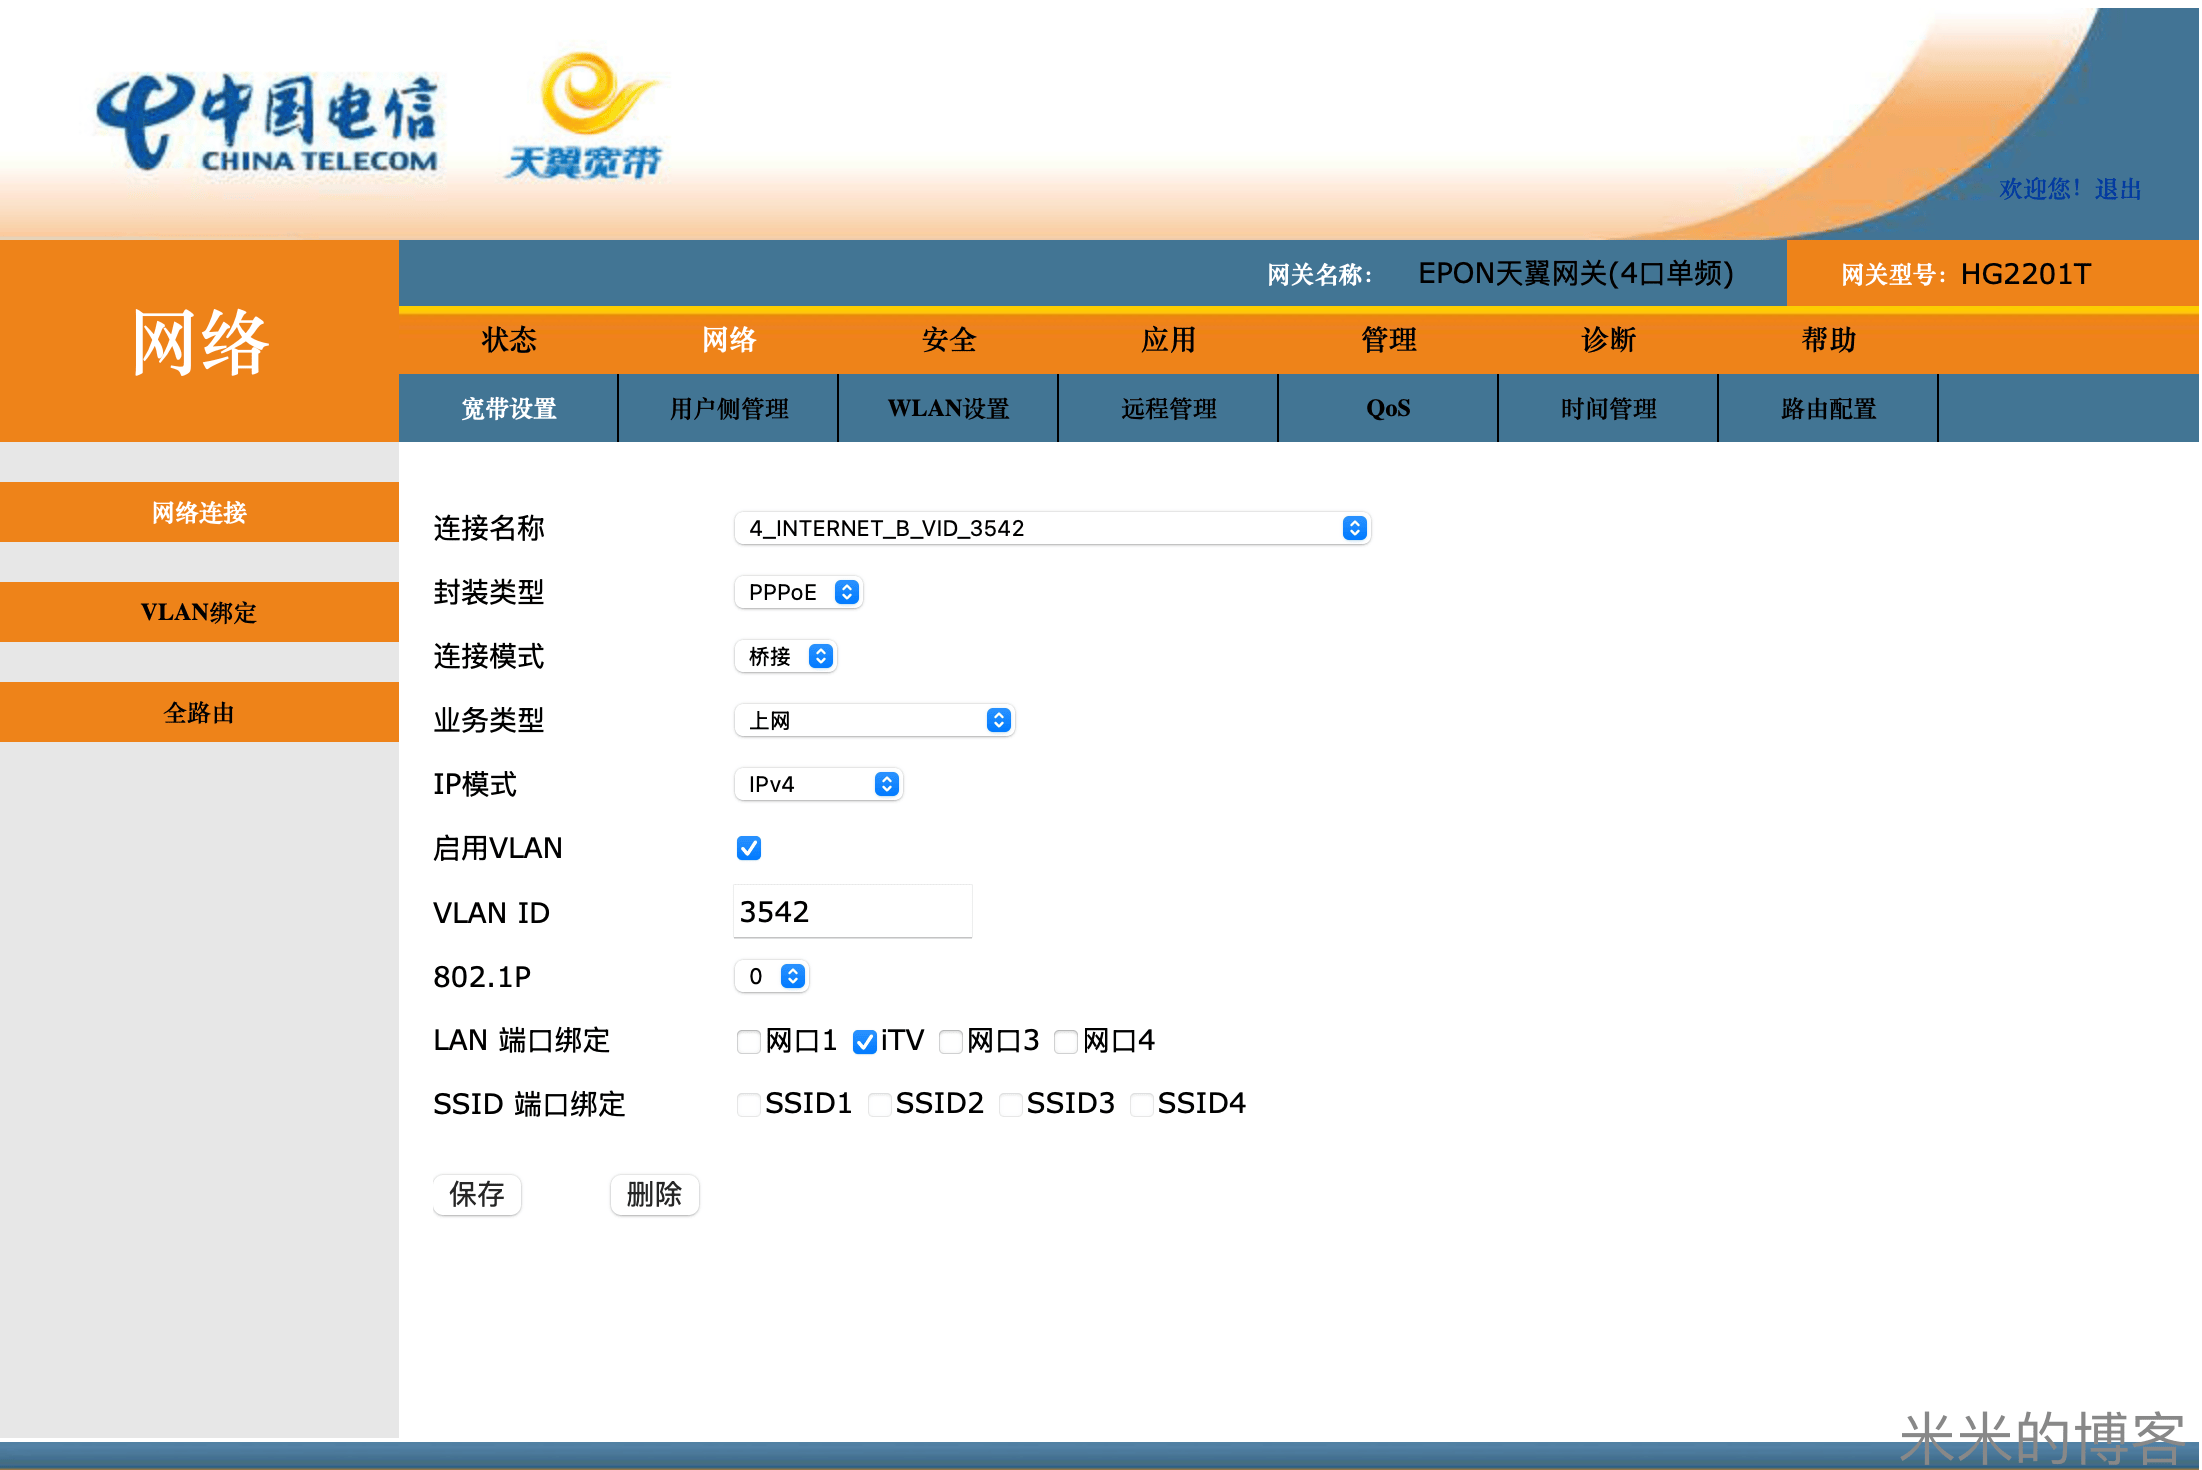
由于这款光猫非常新,一些省份没有入库,所以运营商无法远程下发配置,只能进行手工配置。为了能够正常上网,我们需要在旧光猫上获配置参数,包括旧光猫的逻辑 ID(LOID)、上网和 iTV 的 VLAN ID、PPPoE 账号和密码等。如果有旧光猫的管理员(telecomadmin)密码,可以直接登陆后台查看这些参数。如果没有管理员密码,可以联系电信的师傅帮忙查看。

查看Internet配置

查看iTV配置

配置新光猫

将新光猫接上电源和光纤,用曲别针持续按住复位按钮,直到光猫恢复出厂设置后重新上电。注意,如果按复位按钮的时间不够长,密码不会复原。然后,使用网线连接电脑和光猫的 LAN 口,通过浏览器访问192.168.1.1,使用默认管理员用户名telecomadmin和密码nE7jA%5m登录后台。
随后,访问http://192.168.1.1:8080/opid_setting.cgi,选择所在的省份。此后光猫会再次重启并恢复出厂设置。
之后,再次使用telecomadmin账户和默认密码登录后台,然后访问http://192.168.1.1:8080/system.cgi?telnet点击启用按钮,即可开启 telnet。
这款光猫的 telnet 可以用光猫背后印的useradmin用户及对应的密码登陆,但是登陆后只有普通用户权限。我们需要获取 root 密码(这样可以直接通过 root 用户登录,或者在普通用户 telnet 登录后通过 su 命令提权)。注意,这个 root 密码和 Web 后台的telecomadmin密码是不一样的。它也不会被运营商远程修改。

获取 root 密码

接下来,访问http://192.168.1.1:8080/dumpdatamodel.cgi,得到 XML 格式的光猫配置。在其中搜索SuPassword,可以看到一个 Base64 编码的字符串,这就是 root 密码的 AES 加密形式。我们需要将它解码成明文。笔者做了一个网页小工具,可以帮助解码,地址是:XG-140G-TF (ONU) su 密码计算。将 Base64 字符串粘贴进去,点击解码按钮,就可以得到明文密码。这个密码之后会用到。

Web 界面配置

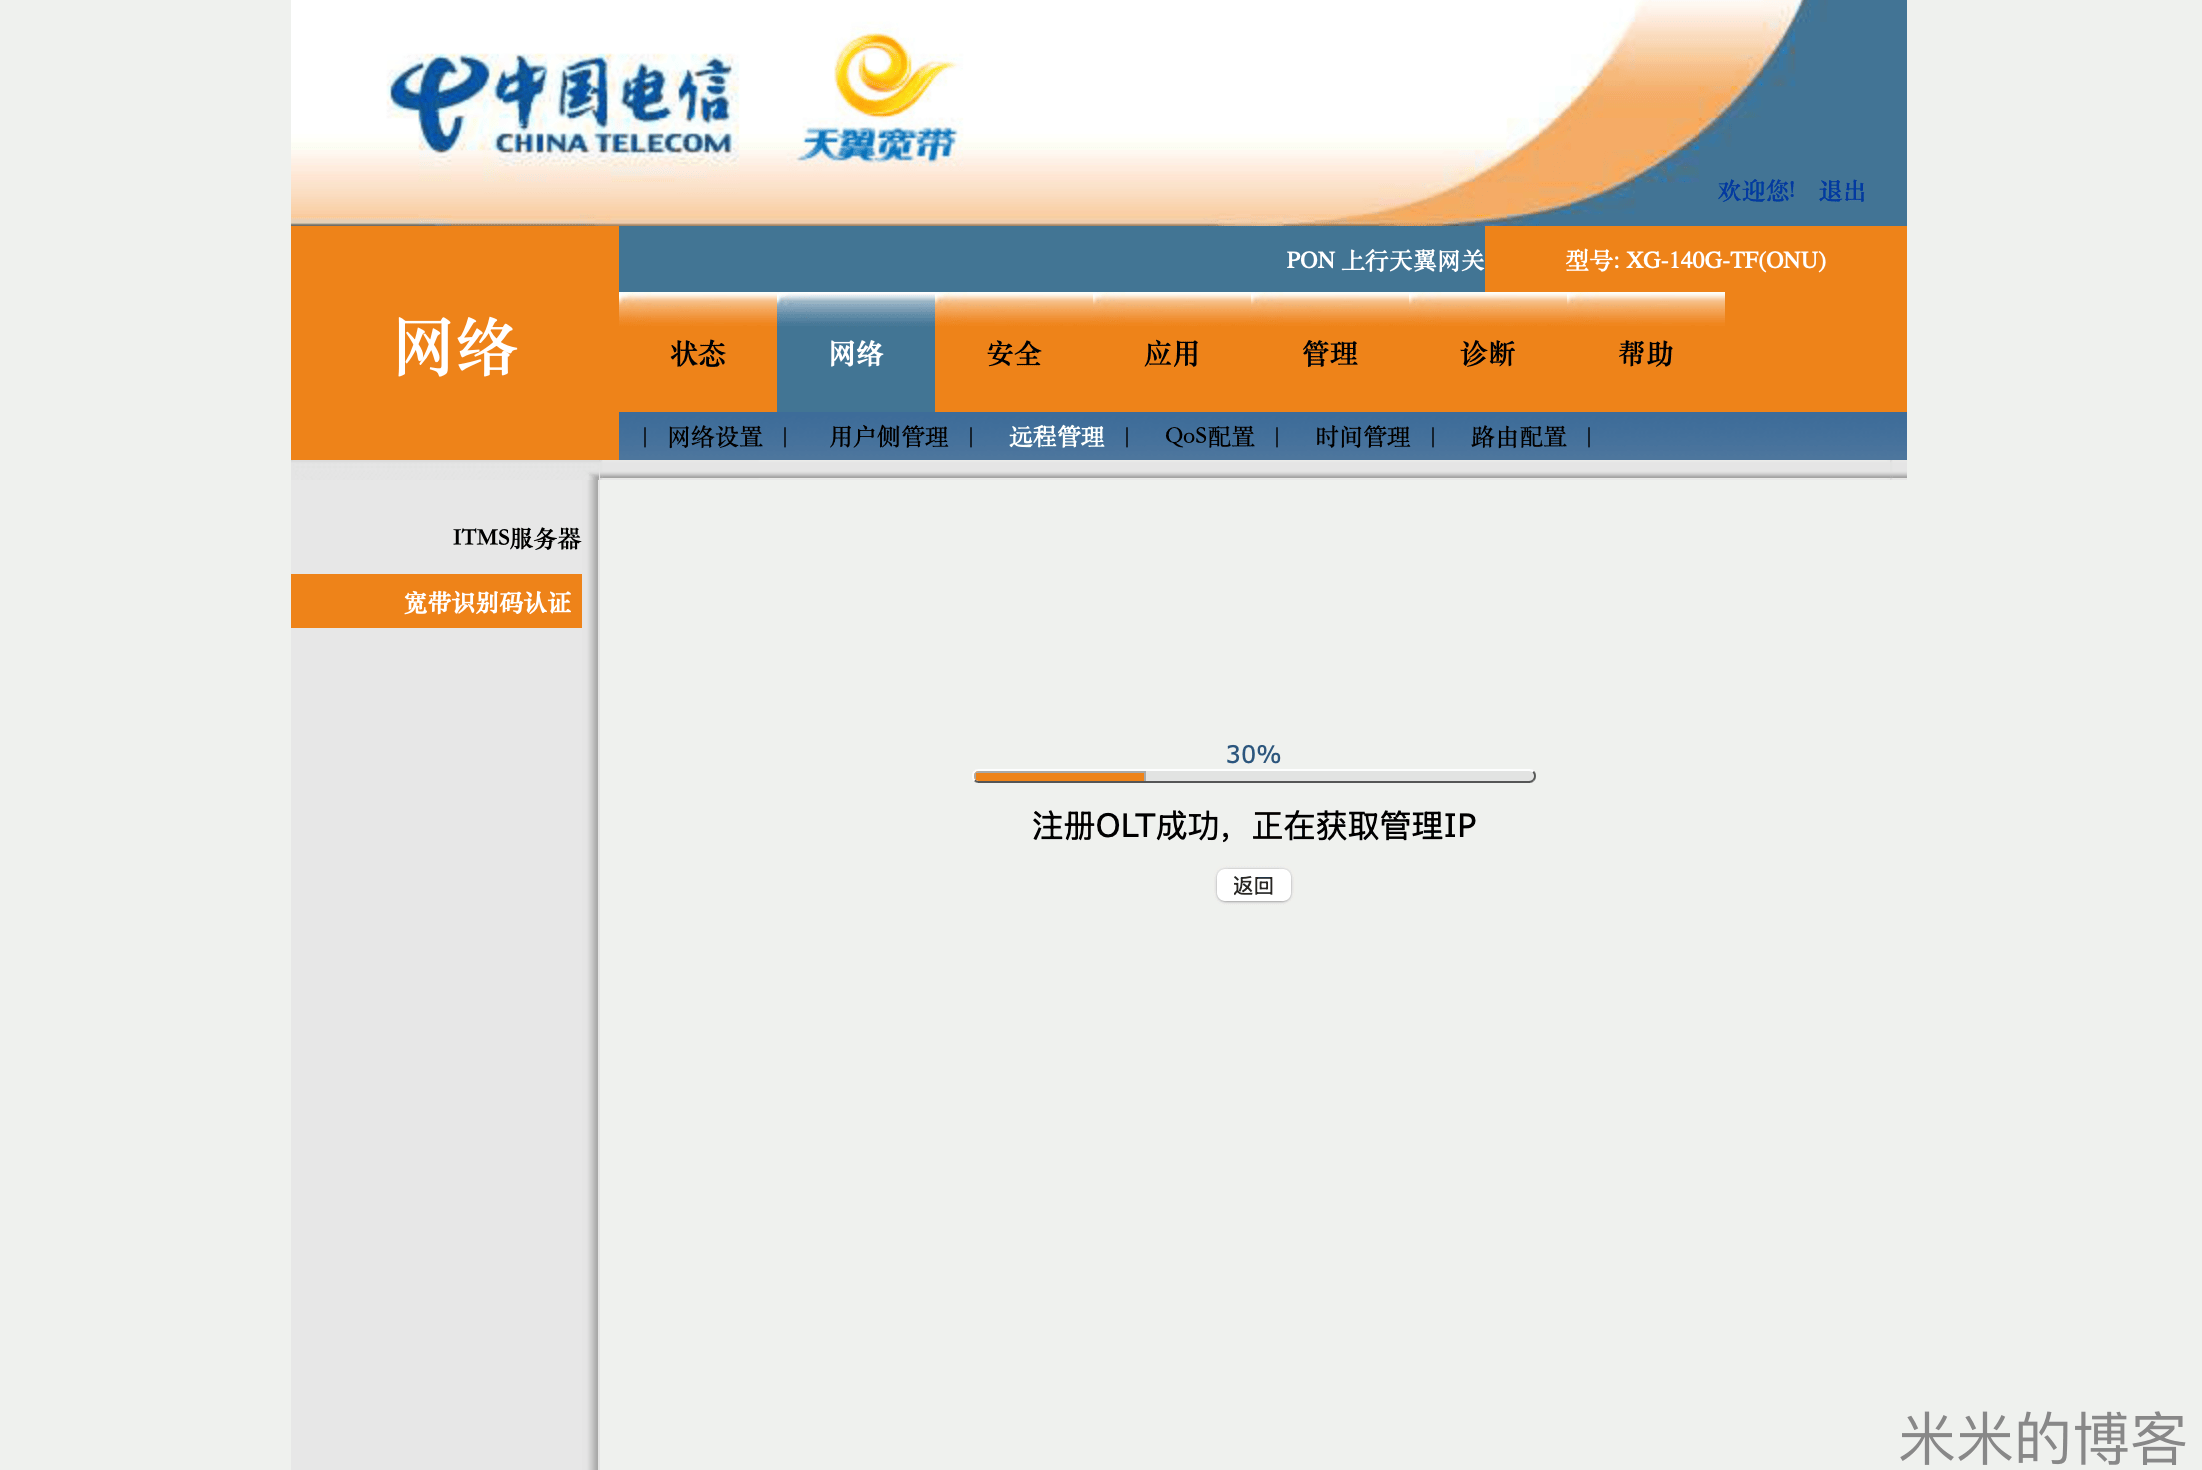
随后,进入光猫的配置界面,点击「网络」 → 「宽带设置」,然后将旧光猫的配置照搬进来即可。之后,找到「网络」 → 「远程管理」界面,选择左侧「宽带识别码认证」菜单,输入逻辑 ID(LOID)进行注册,此处密码似乎不影响,可以留空。

LOID设置

OLT 注册成功后,先前手工进行的网络配置就可以生效了。然而,上网功能还是受到限制。因为光猫没在运营商那里入库,会遇到 ITMS 注册失败,此时光猫会将网络请求劫持到注册页面上。这个问题需要进一步解决。

解决 ITMS 注册失败

为了避免上网出现问题,我们需要让光猫觉得自己已经注册成功。这就需要用到之前的 telnet 账户了。在命令行执行

1
telnet 192.168.1.1

用户名使用root,密码输入先前解码出来的 root 密码,即可以 root 权限登陆。然后,执行

1
2
cfgcli -s InternetGatewayDevice.X_CT-COM_UserInfo.Status 0
cfgcli -s InternetGatewayDevice.X_CT-COM_UserInfo.Result 1

此时,光猫就可以正常工作了。如果设置了桥接模式,可以通过电脑或者主路由进行拨号。

恢复超密

因为注册后超密会被电信更改,所以 telnet 里用命令重新设置超级密码改回nE7jA%5m

1
cfgcli -s InternetGatewayDevice.DeviceInfo.X_CT-COM_TeleComAccount.Password nE7jA%5m

参考文章:
破解 2024 年新款诺基亚贝尔万兆光猫 AES 加密的 su 密码
f78fk 的博客: 分享一下 XG-140G-TF 光猫的使用教程

在日常开发中,经常会遇到 Docker 拉取镜像缓慢、连接不稳定、某些仓库国内访问困难等问题。为了解决这些实际痛点,我实现重复造轮子了一个轻量级 Docker Registry 反向代理,用于中转和加速 Docker 客户端的镜像拉取请求。项目采用 Python + FastAPI 编写,实现了对多个主流仓库的透明代理。

本文将介绍实现背景、设计思路、功能特点以及代码结构,最后提供开源地址,供需要的用户部署使用。

背景

Docker 官方 Registry 对网络质量要求较高,镜像层往往较大。很多场景下,直接从 DockerHub 或 GHCR 拉取镜像会遇到超时、速率不稳定、DNS 污染、IP 限速等问题。

市面上已经有一些现成的镜像代理服务,例如,cloudflare-docker-proxy 提供了能够部署在 Cloudflare Workers 上的代理服务,但是 Docker Hub 已经开始限制通过 Cloudflare Worker 的 IP 访问其服务,导致该代理经常无法正常工作。Docker 官方也提供了基于 OCI Distribution spec 的 registry,但是这样的服务配置复杂,资源要求高,难以在云服务器等环境上部署。在一些轻量级环境中,更希望使用一个灵活性更高、资源占用低的代理。

于是就有了一个目标:

写一个尽量小、足够稳定、可自部署的 Docker Registry 代理,同时保持兼容性。

设计目标

实现这个代理时,我对系统设计目标做了一些规划:

  1. 兼容 Docker Registry API v2
    必须完整支持:

    • GET /v2/
    • GET /v2/auth
    • 获取 manifest / tag / blob 等路径
    • DockerHub 的 library 自动补全规则

    秘诀在于遵循 Docker 客户端的认证流程,模拟 DockerHub 的 WWW-Authenticate 行为。

  2. 流式转发以降低内存消耗
    原始实现如果直接使用 resp.content,会导致 Python 在内存中加载整个 blob,动辄几百兆。这在生产环境是不可接受的。
    最终代理采用 StreamingResponse,将上游的内容以流式方式直接转发,避免占用大量内存。

  3. 支持并发请求
    使用全局 httpx.AsyncClient,依赖其内部连接池来处理多并发,加上 FastAPI 的异步模型,在单 worker 的情况下也能处理多条镜像拉取流水线。

  4. 支持多个仓库
    例如:

    • DockerHub
    • GHCR
    • Quay
    • Google Container Registry
    • Kubernetes Registry

    这些仓库的 API 大致一致,只需要按不同域名路由到不同的上游即可。

整体流程

代理的请求处理流程如下:

  • 客户端访问 docker.example.com/v2/...
  • 代理根据主机名判断应转发至哪个镜像源
  • /v2//v2/auth 按 Docker 协议处理认证
  • repository 路径按需要补全 library/
  • 其它请求以 streaming 方式转发
  • 对 DockerHub 的 blob 307 跳转进行手动跟随
  • 将上游响应回传给 Docker 客户端

整个过程对客户端透明,使其可以像访问官方仓库一样访问自定义域名。

代码结构

项目核心的 streaming 实现基于下面的模式:

1
2
3
4
5
6
7
8
9
req = client.build_request("GET", upstream_url)
upstream_resp = await client.send(req, stream=True)

return StreamingResponse(
upstream_resp.aiter_bytes(),
status_code=upstream_resp.status_code,
headers=response_headers,
background=BackgroundTask(upstream_resp.aclose),
)

开源地址

项目已在 GitHub 开源:

https://github.com/web-llm/fast-docker-proxy

如果你需要一个可控、轻量、可扩展的 Docker Registry 代理,可以直接基于该项目部署,也欢迎提交 issue 或 PR。具体使用方法请参考仓库的 README 文档。

我在一台阿里云轻量云服务器上部署了 VS Code Server,用于远程开发。这台服务器配置为 2 核 CPU + 2GB 内存,我额外添加了 8GB 的 swap,希望应对 VS Code Server 启动后的内存压力。然而,在实际使用中,每次通过 SSH 启动 VS Code Server 后不久,服务器就会失去响应,SSH 连接中断,必须强制重启机器。

起初我怀疑是内存不足或 swap 设置不当导致的系统崩溃,但深入排查之后,发现真正的问题其实来自系统对 inotify 监听器数量的限制。通过调整 fs.inotify.max_user_watches 参数,问题得以彻底解决。

下面是我的排查过程与最终的解决方案。

初步怀疑:内存不足和 swap 设置

由于 VS Code Server 启动时会拉起大量语言服务器、插件和文件监听器,在初次遇到 SSH 连接中断后,我第一时间怀疑是内存不足导致的。通过 dmesgfree -h 查看系统日志和内存状态,发现 VS Code Server 启动后确实存在内存紧张的情况。

我尝试通过增加 swap 空间到 8GB 来缓解压力,具体做法可以参考之前的文章 Linux 下增加、删除 Swap 文件。然而,问题依旧没有解决。SSH 连接依然在 VS Code 启动后不久被挂起,系统无法及时响应新连接,甚至无法正常关机。

进一步调查:监控进程和系统调用

我观察到在 VS Code Server 启动后,nodetsserver 进程数量迅速上升,内存占用随之增高,同时系统 I/O 等待时间变得非常长。用 vmstatps 工具查看系统状态时,也看到了频繁的文件访问和上下文切换。

这让我开始怀疑是否是文件系统监听器数量过多导致系统资源耗尽。VS Code 和许多语言服务器会使用 inotify 机制监听文件变化,用于自动刷新和提示功能。而 Linux 对每个用户可以创建的 inotify 监听器数量是有限制的。

找到真正的问题:inotify 限制过低

通过查看 /proc/sys/fs/inotify/max_user_watches,我发现默认值仅为 8192。这对于一个包含多个项目文件夹和自动索引的开发环境来说,远远不够。

一旦监听器数量超限,VS Code Server 中的插件和语言服务器就会频繁尝试重新监听文件,占用大量资源,最终导致系统进入无法响应的状态。这也解释了为什么增加 swap 并没有改善情况:问题其实不是内存不足本身。

解决方案:提高 max_user_watches 限额

确定问题之后,我通过以下方式修改了系统配置:

首先临时调整参数:

1
sudo sysctl fs.inotify.max_user_watches=65536

然后将其写入配置文件以永久生效:

1
2
echo fs.inotify.max_user_watches=65536 | sudo tee -a /etc/sysctl.conf
sudo sysctl -p

重启服务器后再次连接 VS Code Server,问题彻底消失。无论打开多少项目或运行多少扩展,服务器都能够稳定运行,系统资源使用保持正常。

总结

云服务器内存有限时运行 VS Code Server,常见的建议是增加 swap、限制语言服务器内存或禁用部分扩展。然而,如果系统在 VS Code 启动后迅速失去响应,除了内存问题,还应特别注意 inotify 的限制。

在我遇到的案例中,虽然最初误以为是内存瓶颈,最终发现是 fs.inotify.max_user_watches 太低导致的资源耗尽。只需简单提升监听器上限,就能让 VS Code Server 在低配服务器上运行得更加稳定流畅。

如果你也在远程开发中遇到类似问题,不妨检查一下这个关键参数。

0%